Hur mycket RAM behöver din laptop för att köra AI lokalt?
En kompakt AI-modell kan redan läsa text och bilder och besvara dina frågor på din egen laptop, utan att du behöver något molnkonto. Ladda ner qwen3.5:4b-q4_K_M (Qwen) i kväll. Filen är på 3,4 GB och modellen kan göra precis det på en vanlig laptop med 16 GB RAM. Det är en så kallad LLM, eller stor språkmodell. Hämta modellen med Ollama, ställ en fråga med 4K-kontext, och du kör en riktig AI-modell lokalt på hårdvara du redan har. Den kan läsa text och bilder, och det handlar om inferens, inte träning: ingen lär modellen något nytt här, den svarar bara.
En vag etikett som ”AI PC” på kartongen är ingen specifikation. Det som spelar roll är RAM, minnet som GPU:n kan använda, lagring och faktiskt mjukvarustöd. 16 GB minne är en verklig startpunkt för små AI-modeller, inte något att avfärda, men inte heller ett löfte om allt som står i specifikationsbladet. Mer minne ger mer kontext och bättre marginal för flera uppgifter samtidigt. Kort sagt: 16 GB räcker för att komma igång.
Det som använder RAM när du kör AI på din laptop
En modells nedladdningsstorlek och hur mycket RAM den använder när den körs är två olika saker. Att blanda ihop dem är det vanligaste misstaget när man letar laptop för AI. De 3,4 GB du laddar ner för qwen3.5:4b-q4_K_M är filen på disken. För att ladda modellen krävs riktigt minne. Detsamma gäller kontextfönstret, alltså den pågående konversation som modellen håller i minnet när den svarar, den så kallade KV-cachen. Själva motorn kräver också minne, liksom operativsystemet och andra appar som redan är igång.
Ollama använder som standard en kontext på 4 096 token, och du kan höja den. Kör du flera förfrågningar samtidigt ökar minnesbehovet för kontext ungefär i takt med antalet parallella förfrågningar. Ett specifikationsblad kan ange ett kontextfönster på 128K eller 256K token, men se det som modellens tak, inte som ett löfte om att din laptop med 16 GB kan använda allt på en gång.
RAM, VRAM och enhetligt minne är inte samma sak
Apple Silicon-chip använder enhetligt minne: CPU och GPU delar på samma pool på 16, 24 eller 32 GB, så det finns inget separat grafikminne som kan ta slut. En vanlig Windows- eller Linux-laptop med ett dedikerat NVIDIA-grafikkort fungerar annorlunda. Systemets RAM och grafikprocessorns eget VRAM är två separata pooler, och 16 GB system-RAM plus ett grafikkort med 8 GB är inte en enda pool på 24 GB som modellen fritt kan använda.
När en modell inte får plats helt i GPU:n körs en del av den på CPU:n i stället. Den typen av delvis avlastning kan göra att en modell som tekniskt går att ladda ändå känns märkbart långsammare. Kör så ser du exakt hur fördelningen mellan CPU och GPU ser ut för det som är laddat just nu.
Kapacitet är bara halva bilden. Hur snabbt minnet kan flytta data spelar lika stor roll. Apple anger 153 GB/s minnesbandbredd för MacBook Air M5, och bandbredd, inte bara storlek, är en viktig del av varför enhetligt minne känns snabbt i praktiken i stället för att bara vara tekniskt tillräckligt.
Kvantisering: så får en AI-modell på 9B plats i ditt RAM
Kvantisering är det som ligger bakom nedladdningen på 3,4 GB: när en modells vikter lagras med lägre numerisk precision blir filen mindre, och Qwen3.5:s egen 9B-modell visar spannet tydligt. Samma 9B-modell laddas ner som 6,6 GB i Q4_K_M, 11 GB i Q8_0 och 19 GB i full BF16-precision. Samma modell, samma antal parametrar, tre väldigt olika nedladdningsstorlekar, och återigen gäller det filstorleken, inte hur mycket RAM som krävs när modellen körs.
Lägre precision kostar vanligtvis en del kvalitet, men hur mycket beror på uppgiften, inte på någon fast procentsats. En praktisk detalj innan du väljer Qwen som första modell: vissa användare upplever att modellens ”tänkande”-steg ger en tydlig fördröjning innan svaret kommer, jämfört med modeller som svarar mer direkt. Därför kan det vara värt att testa båda varianterna på dina egna uppgifter i stället för att utgå från att den ena helt enkelt är bättre.
Har du redan en MacBook med 16 GB? Börja här innan du köper något
Om du redan har en MacBook med 16 GB, börja med en modell på 2-4B i Q4-precision och 4K-kontext innan du ens funderar på att köpa något annat. En 9B-modell i Q4, eller något som Gemma 4 12B QAT, kan också gå att ladda. Om det fungerar beror på hur många andra appar som är öppna, hur mycket kontext du använder och hur varm datorn redan är, så se det som något att prova, inte som garanterat.
Ska du köpa nytt just för det här? MacBook Air 13 tum med M5-chip kommer med 16 GB enhetligt minne som standard och kan konfigureras upp till 32 GB. Och innan du låter den större skärmen kännas som en uppgradering: 15-tums M5 Air börjar med exakt samma minnesalternativ på 16, 24 och 32 GB och samma bandbredd på 153 GB/s som 13-tumsmodellen. Välj skärmstorlek efter komfort, inte för att du tror att den ger mer AI-marginal. Det gör den inte.

Har du redan en Windows- eller Linux-laptop med 16 GB? Börja här
En Windows- eller Linux-laptop med 16 GB utan dedikerad GPU kan fortfarande köra en liten modell. Ollama körs direkt i Windows, så hämta en 2-4B-modell i Q4 och testa den på CPU:n eller den integrerade grafiken innan du lägger pengar på något. Räkna med större variation än på Apple Silicon: det finns inget fast tal för token per sekund som gäller för alla datorer, eftersom ingen har mätt varje enskild konfiguration.
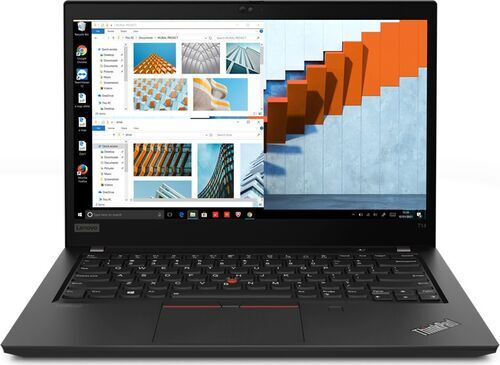
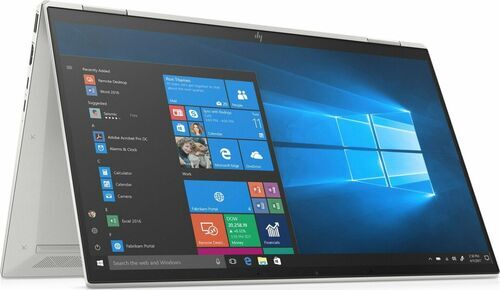
Lenovo ThinkPad T14 G2 och HP EliteBook x360 1040 G7 har båda 16 GB RAM och integrerad grafik, alltså precis den här nivån. En sak som är värd att kontrollera först, särskilt på en äldre rekonditionerad dator som någon av dessa: LM Studio kräver stöd för AVX2 i Windows x64, ett instruktionsset som inte finns i alla äldre processorer. Kontrollera att just din processor stöder det innan du utgår från att vilken laptop som helst i den här klassen kan köra verktyget du har valt.
Fällan med namn på laptop-GPU:er: varför ”RTX 5070 Ti” inte säger allt
NVIDIAs laptop-GPU:er delar namn med stationära grafikkort, och det namnet säger mindre än man kan tro. RTX 5060 Laptop GPU har 8 GB GDDR7-minne och ett angivet effektspann på 45 till 100 watt. RTX 5070 Ti Laptop GPU har 12 GB GDDR7 och 60 till 115 watt. Ett resultat på nätet för ett stationärt RTX 5070 Ti är inte samma sak som ett resultat för RTX 5070 Ti Laptop GPU, oavsett vad namnet antyder.
Det finns en andra fälla i samma namn. Två laptops kan båda ha en ”RTX 5070 Ti Laptop GPU” och ändå prestera olika under längre belastning: ett tunt och lätt chassi och ett tjockare och tyngre chassi hanterar värme olika, och samma GPU-namn garanterar inte samma verkliga hastighet när fläktarna har jobbat ett tag. Kontrollera alltid exakt mängd VRAM och laptopens egen effektkonfiguration, inte bara vilken GPU-familj den tillhör.
Köper du Mac för det här? Den bekvämare nivån med enhetligt minne
Om du köper just för att köra lokal AI regelbundet är 24 till 32 GB enhetligt minne den bekvämare Apple-nivån: det ger verklig marginal för en större modell, längre kontext eller helt enkelt fler öppna appar medan du jobbar. Välj 32 GB om du tror att du kommer att använda det här ofta och budgeten tillåter det.
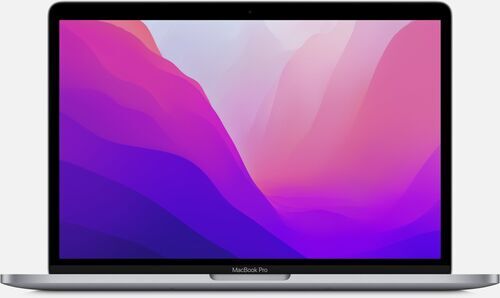
MacBook Pro 13 tum med M2-chip är ett konkret rekonditionerat exempel som redan ligger över startnivån på 16 GB: den kombinerar en 8-kärnig CPU och en 10-kärnig GPU med upp till 24 GB enhetligt minne. Det är en äldre chipgeneration än M5 Air, så här är det modellens eget tak på 24 GB som gäller, inte M5 Airs separata konfigurationsalternativ på 24 och 32 GB.
Köper du Windows eller Linux för det här? Titta efter dedikerad GPU
Om du köper en ny Windows- eller Linux-laptop med lokal AI som huvudsyfte, sikta på 32 GB system-RAM tillsammans med en dedikerad NVIDIA laptop-GPU med minst 8 GB eget VRAM, och gärna 12 GB om du kan acceptera en lite tyngre eller dyrare laptop. 8 GB är en rimlig nivå för modeller på 4-7B i Q4-precision med måttlig kontext, men utgå inte från att det automatiskt ger gott om marginal. Till och med en nedladdning på 6,6 GB för en 9B-modell i Q4 kan behöva mer än just 8 GB för att fungera bekvämt, och 12 GB gör det helt enkelt lättare att testa i den storleken.
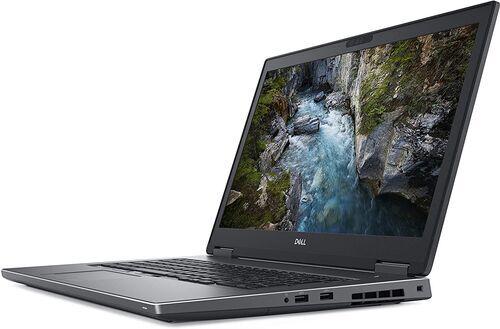
Dell Precision 7730 är ett konkret rekonditionerat exempel på grundidén, även om den inte har exakt samma nya chip som ovan: 32 GB systemminne kombineras med ett dedikerat NVIDIA Quadro P3200 med egna 6 GB VRAM, alltså en annan GPU-generation och klass än dagens RTX 5060 och 5070 Ti Laptop GPU från NVIDIA, men enligt samma princip med separata minnespooler.

Ett alternativ värt att titta närmare på: AMD:s laptopchip med mycket minne
AMD:s processor Ryzen AI Max+ 395 stöder upp till 128 GB LPDDR5x-systemminne, beroende på hur den färdiga datorn är konfigurerad. Det är en annan minnesarkitektur som är värd att känna till, men med en viktig hake: i Ollamas Linux-lista för ROCm-stöd finns chippet med, medan det just nu inte finns med i ROCm-listan för Windows.
Det är en anledning att kontrollera exakt installerat minne, operativsystem, GPU-backend, drivrutin och hur Ollama fungerar på en specifik laptop innan man rekommenderar den, inte en anledning att avfärda chippet direkt. Se därför en laptop med mycket minne från AMD som en intressant alternativ arkitektur som förtjänar noggrann research, inte som det självklara förstaköpet för någon som är ny på att köra AI lokalt.
Mjukvarulagret: Ollama och LM Studio i klarspråk
Ollama är det enklaste sättet att få en modell att börja svara på din egen dator: hämta en modell, kör den, och du har en lokal server som svarar på förfrågningar, utan att något molnkonto krävs för en modell du har laddat ner. Det är verktyget bakom alla exempel här.
LM Studio är ett grafiskt alternativ med egen modellbläddrare och chattfönster. Programmet anger sina egna minimikrav: minst 16 GB RAM på Mac eller Windows, AVX2-stöd krävs på Windows x64 och 4 GB dedikerat VRAM rekommenderas på Windows. Att sätta upp något av dem ordentligt är ett eget ämne.
En varning innan du litar på ett enskilt hastighetstal på nätet: det officiella verktyget llama-bench skiljer mellan hastighet för promptbearbetning och hastighet för generering, och visar variation mellan upprepade testkörningar i stället för bara en siffra. Ett foruminlägg som citerar ett enda tal för token per sekund säger sällan vilken av de två mätningarna som avses, eller hur många gånger testet kördes.
Checklista när du ska köpa eller uppgradera till en AI-redo laptop
Innan du köper eller uppgraderar just för lokal AI, titta på detaljerna i stället för marknadsföringen.
Exakt GPU-modell och mängd VRAM. Inte bara GPU-familjen, utan den exakta laptopvarianten och hur mycket eget minne den har, eftersom samma namn kan dölja olika mängder VRAM.
Fastlött eller uppgraderingsbart RAM. Vissa laptops låter dig lägga till mer minne senare, många moderna tunna och lätta modeller gör det inte. Ta reda på vilket du köper.
Ledigt SSD-utrymme. Modellnedladdningar varierar från under en gigabyte till långt över tio, och en växande samling tar snabbt plats bredvid dina andra filer.
Värmebeteende under längre belastning. En modell som svarar på en fråga och en laptop som hanterar flera förfrågningar i rad är två olika tester. Fläktljud och strypt prestanda efter upprepade promptar säger mer än en enda snabb demo.
Stöd för operativsystem och drivrutiner. Kontrollera att just din kombination av GPU-backend och operativsystem stöds av Ollama eller LM Studio innan du utgår från det.
NPU-siffran i TOPS på kartongen är ingen garanti för genomströmning. Det är en marknadsföringssiffra, inte ett testresultat från motorn du faktiskt kommer att köra. En vag etikett som ”AI PC” ersätter inte någon av kontrollerna ovan.
Fem rekonditionerade laptops som redan matchar de här nivåerna

Vanliga frågor om att köra AI på en laptop
Behöver jag en dedikerad GPU för att köra AI lokalt?
Nej. En liten modell kan köras på CPU eller integrerad grafik på många laptops med 16 GB, bara med större variation i hastighet än på en laptop med dedikerad GPU. Börja med en 2-4B-modell innan du utgår från att du över huvud taget behöver dedikerad grafik.
Fungerar 8 GB RAM?
Inte bekvämt för modellerna som tas upp här. 16 GB är den realistiska startpunkten när man räknar in att modellen, dess kontextfönster, motorn och operativsystemet delar på samma minne.
Är det samma sak att köra en modell lokalt som att träna en?
Nej. Allt ovan handlar om inferens: att ställa frågor till en redan tränad modell. Träning bygger en modell från grunden och kräver mycket mer hårdvara än någon av laptopsen här.
Garanterar mer RAM snabbare svar?
Nej. Mer minne ger mer marginal för större modeller, längre kontext och fler öppna appar, men den verkliga hastigheten beror på minnesbandbredd, GPU-backend och den specifika modellen, inte bara på mängden minne.
Är min data privat när modellen körs lokalt?
Ja, i den meningen att dina promptar stannar på din dator i stället för att gå till en molnleverantör. Ollama binder som standard till din egen laptop och skickar inga förfrågningar någon annanstans om du inte medvetet ställer in molnåtkomst.
Testa i kväll, och köp sedan med bättre koll
Har du redan en laptop med 16 GB? Installera Ollama i kväll och kör en liten modell innan du lägger en krona på något nytt. Köper du just för det här? Använd checklistan ovan och de fem rekonditionerade laptops vi just gått igenom som första jämförelsepunkt, i stället för att bara lita på ett marknadsfört specifikationsblad.
Varje laptop på refurbed testas och bedöms innan den läggs upp, så det RAM-minne och den konfiguration du köper är också det RAM-minne och den konfiguration du får. Nästa guide i den här serien går igenom hur du kopplar din första app till modellen du just har testat.


Anmäl dig till vårt nyhetsbrev för första gången och spara 200 kr!
Missa aldrig ett erbjudande igen.
Information om användningen av personuppgifter finns i vår Integritetspolicy.
Ladda ner refurbed appen
För iOS och Android


Bekräfta registrering
Klicka på länken i bekräftelsemailet för att få din rabattkod. Den gäller på köp för över 3000 kr.
- © Refurbed Marketplace GmbH
- Tillgänglighet
- Allmänna villkor
- Integritetspolicy
- Imprint
- Legal Notices
- European Data Act
- Cookie Policy